Observabilité à grande échelle : du cadrage à l’autonomie des équipes
Du cadrage à l’amélioration continue en RUN, nos retours de terrain pour déployer l’observabilité et faire progresser l’autonomie des équipes.

Déployer une plateforme d’observabilité à grande échelle engage autant l’organisation que la technique. Nos retours de terrain montrent un parcours fréquent : l’enthousiasme du lancement se heurte aux contraintes du SI et aux résistances au changement. L’accompagnement consiste à franchir ce cap, jusqu’à des usages utiles et des équipes progressivement autonomes.
Garder un cap métier tout au long du projet
Chez Phenisys, nous relions le cadrage aux cas d’usage prioritaires : suivre un processus métier de bout en bout, comprendre une dégradation applicative ou étendre la visibilité au réseau et aux logs. Une feuille de route partagée donne une direction au déploiement et permet de rationaliser les usages lorsque les premières difficultés apparaissent.
Le conseil se prolonge dans l’intégration : construction du socle, définition de bonnes pratiques, raccordement aux référentiels existants et extension progressive de la couverture. La trajectoire dépend des priorités du client et de la capacité des équipes à s’approprier chaque étape.
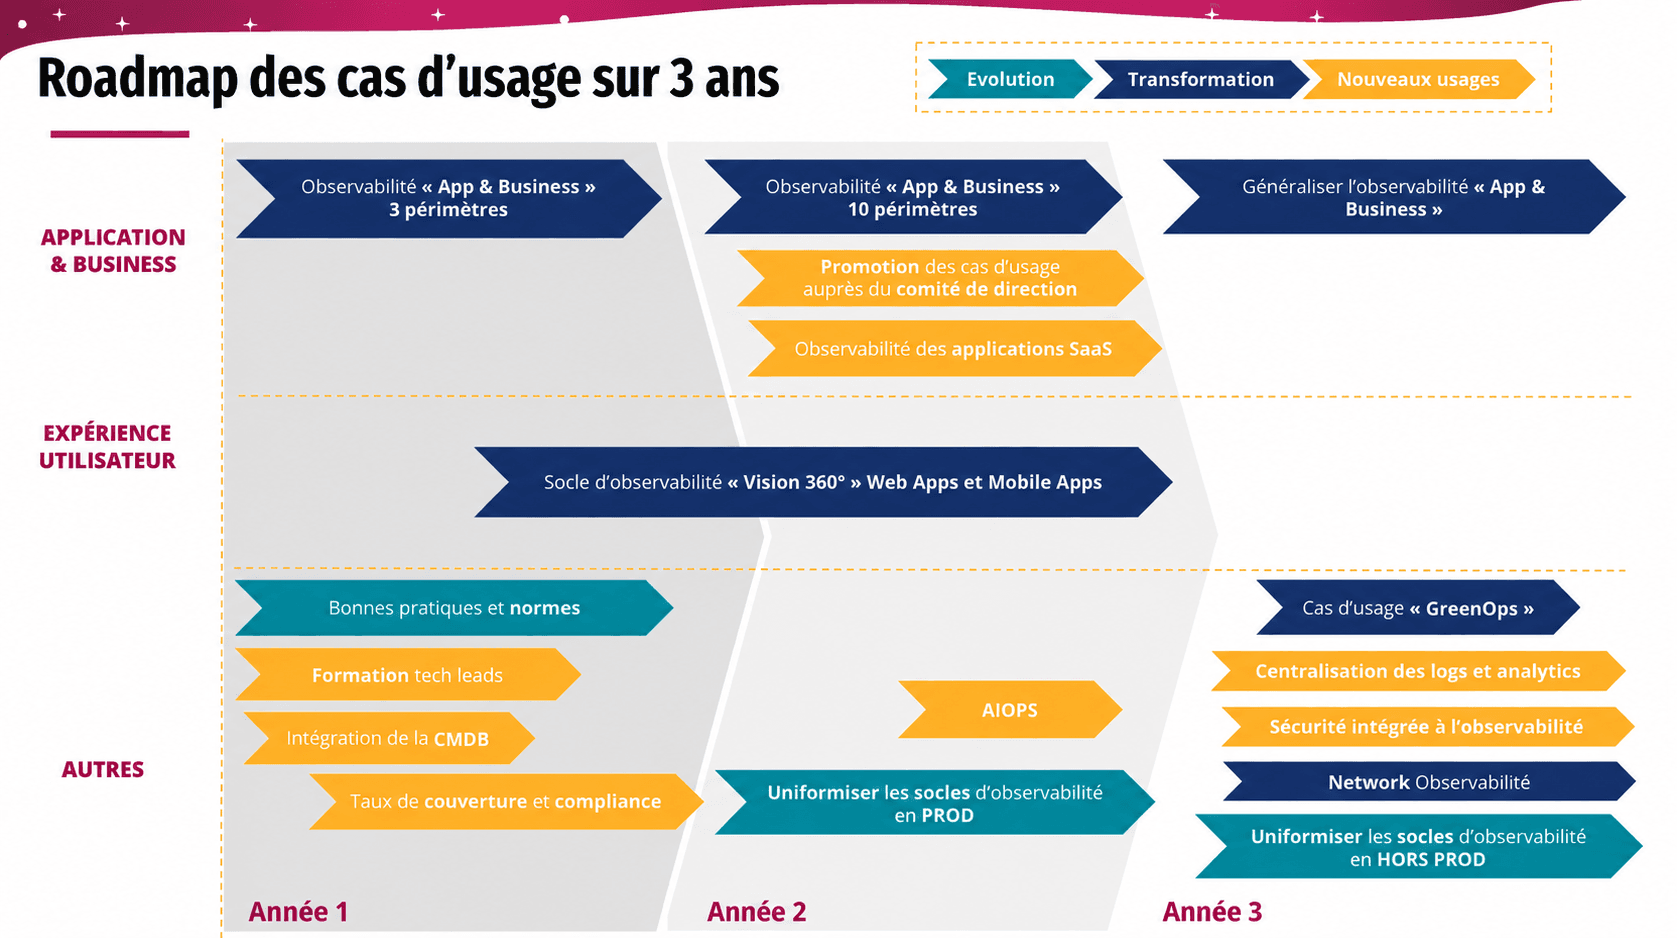
Feuille de route sur trois ans : le socle, la formation et les premiers périmètres précèdent l’extension des usages.
Intégrer l’observabilité aux opérations : 60 % de bruit en moins
Chez un client, l’enjeu était de diminuer les doublons et les tickets ouverts dans l’outil de gestion des incidents. Après un premier travail du client sur la réduction des alertes, Phenisys a accompagné la mise en place d’une déduplication en amont de la création des tickets.
Le traitement distingue un nouvel incident, qui déclenche une ouverture, d’un doublon ou d’une récurrence, qui enrichit un ticket existant. Des règles explicites et traçables, ainsi que la supervision du workflow lui-même, rendent la chaîne plus maîtrisable. La simplification du routage et de l’enrichissement réduit également le nombre d’outils intermédiaires.
La démarche a permis de réduire le bruit d’environ 60 %.
Un workflow pour traiter les récurrences
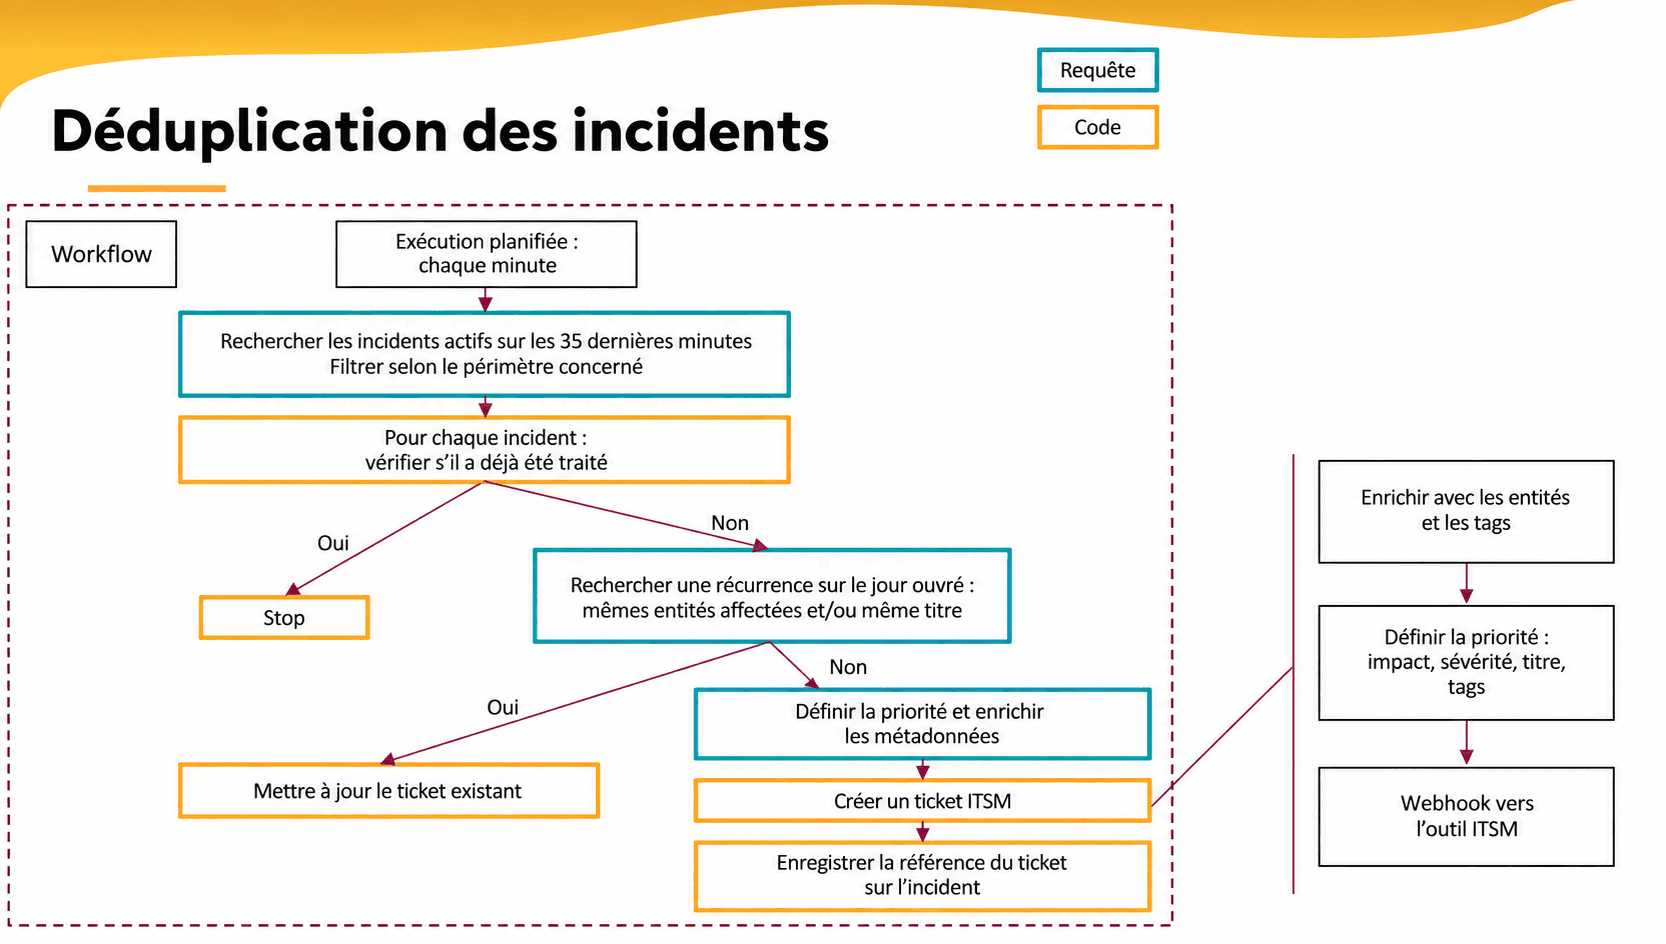
Une exécution planifiée recherche les incidents actifs, écarte ceux déjà traités puis recherche une récurrence sur les entités affectées et/ou le titre. Une récurrence enrichit le ticket existant ; un nouvel incident déclenche sa création, avec priorité et métadonnées. La référence du ticket est conservée pour assurer le suivi.
Le workflow dans la plateforme et son suivi
Le workflow s’exécute directement dans la plateforme d’Observabilité et exploite l’ensemble de ses données : événements, entités, contexte et historique des incidents. Ces données servent de déclencheurs aux interactions avec l’ITSM (gestion des services IT) et alimentent l’analytics des tickets pour décider lesquels créer, enrichir ou fermer selon les règles définies. L’orchestration et son suivi restent ainsi au plus près des données qui justifient chaque action.
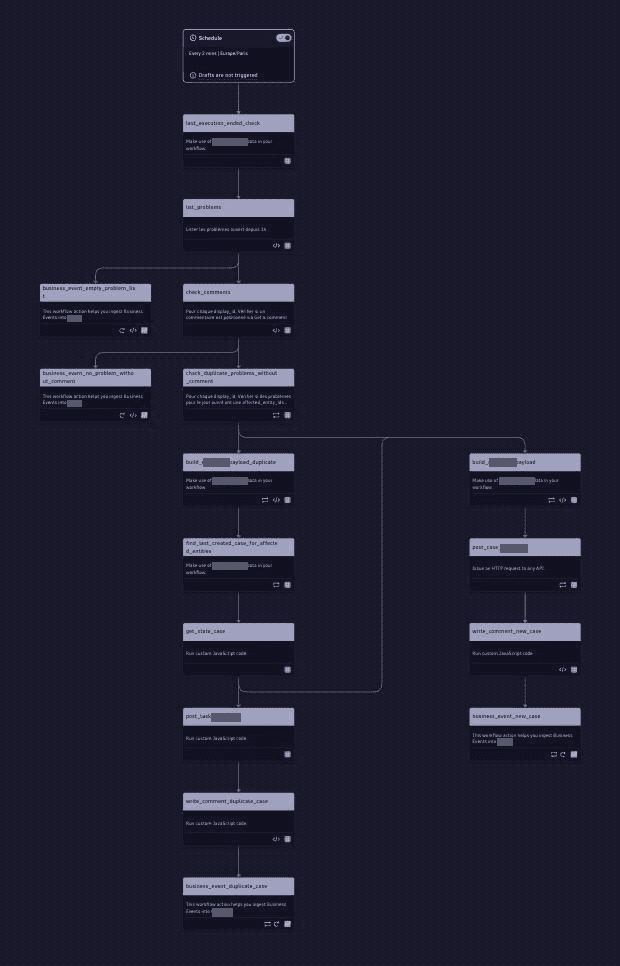
Le workflow dans l’outil : après la recherche des incidents et le contrôle des commentaires, les branches distinguent les récurrences des nouveaux cas. Les étapes préparent les données, interrogent l’état du ticket et appellent l’ITSM, puis enregistrent les commentaires et événements nécessaires à la traçabilité.
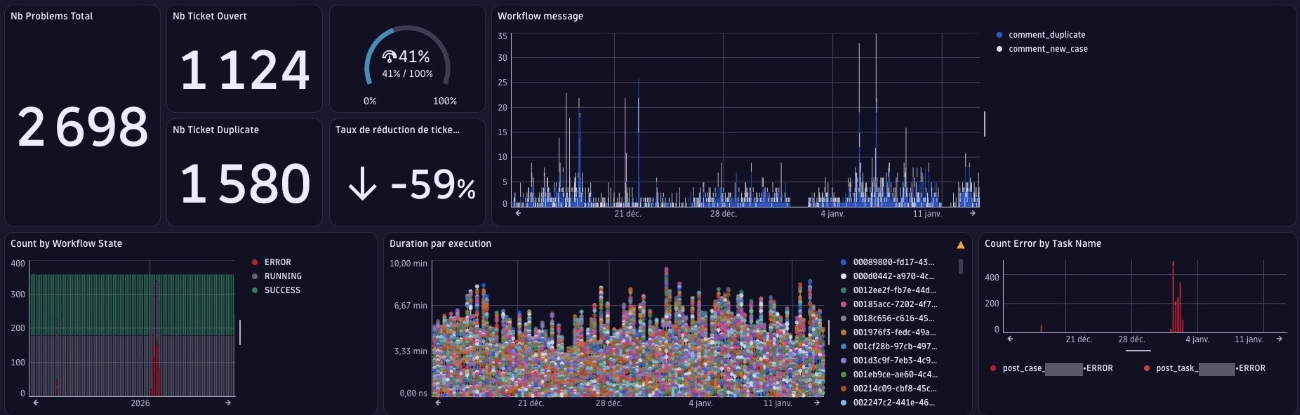
Le tableau de bord affiche 2 698 problèmes, 1 124 tickets ouverts, 1 580 doublons et une réduction de 59 %, soit environ 60 %. Il suit aussi les états du workflow, les durées d’exécution et les erreurs par tâche, afin de surveiller le fonctionnement de l’automatisation autant que son effet sur le volume de tickets.
Préparer l’autonomie dès la construction du socle
L’adoption se travaille pendant le projet. Nous associons les équipes dès la construction, animons des ateliers de transfert de compétences et contribuons à faire émerger des champions internes. Des tableaux de bord adaptés, des points d’entrée simples et des cas d’usage partagés donnent aux équipes des moyens concrets d’agir.
Dans deux accompagnements, cette dynamique s’est prolongée par la création de clubs utilisateurs internes. Ces rendez-vous permettent de partager les pratiques et d’étendre l’observabilité à de nouvelles équipes, au-delà du noyau initial.
Faire du RUN une amélioration continue
Une fois le socle en place, l’accompagnement porte aussi sur la gouvernance : suivi de la consommation, taux de couverture et usages réels. Ces repères aident à orienter les évolutions et à garder une consommation cohérente avec les besoins.
Relier la consommation aux usages
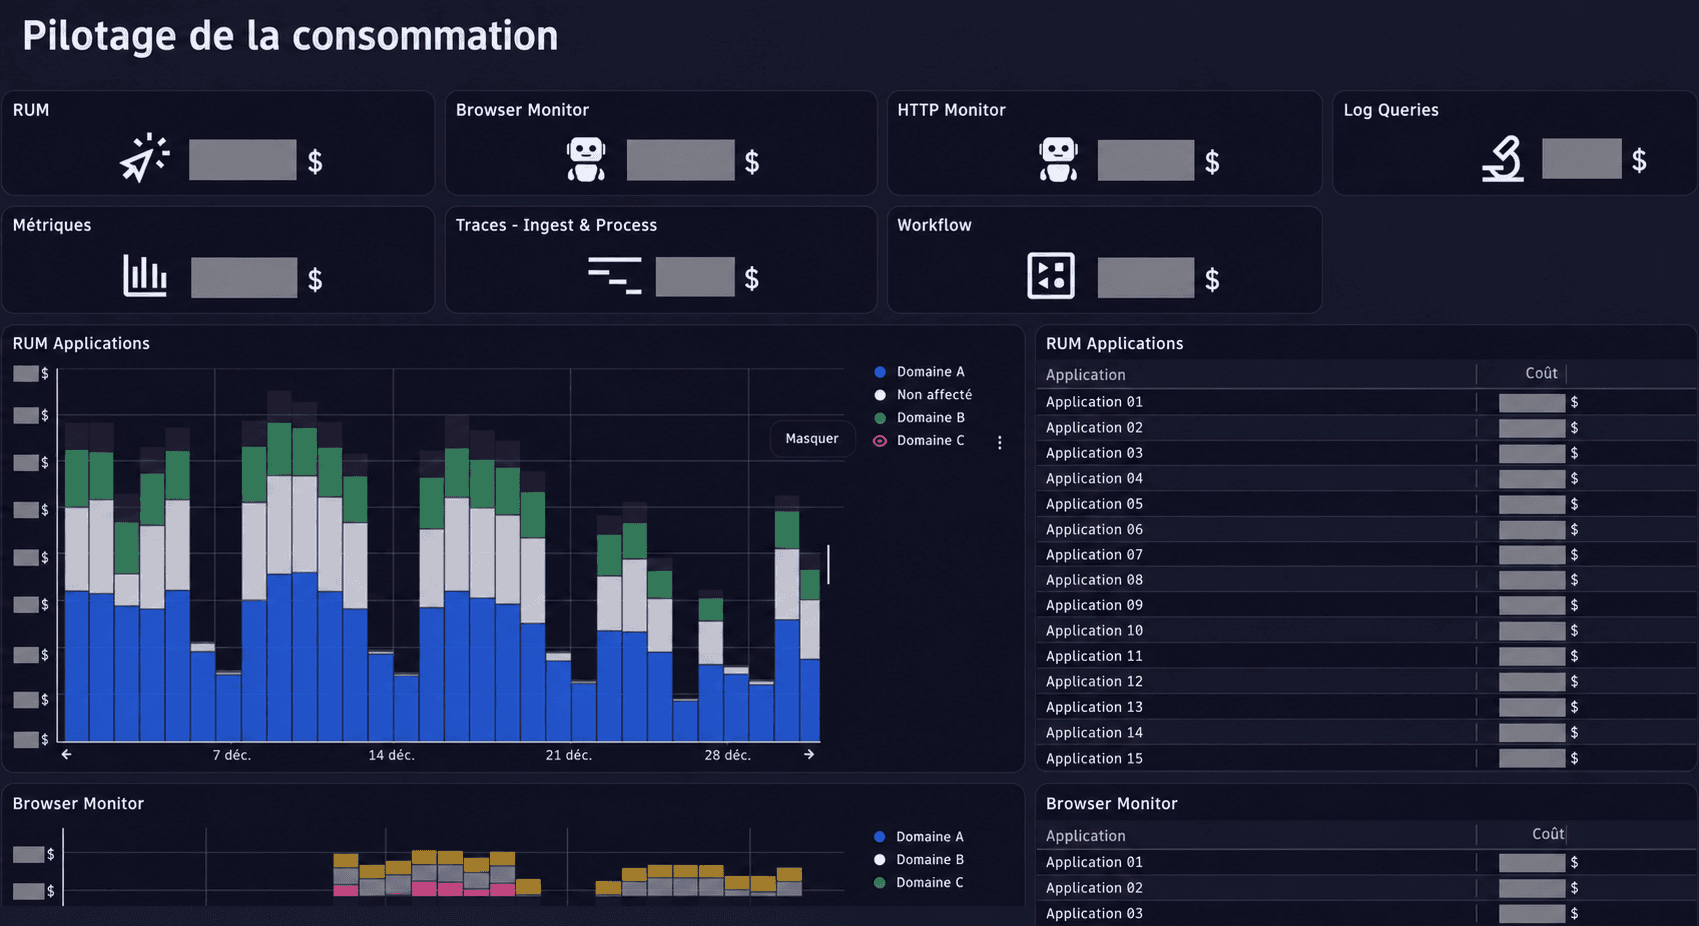
Les tuiles séparent les postes de consommation : expérience utilisateur, tests synthétiques, métriques, traces, requêtes sur les logs et workflows. L’historique et le détail par application permettent de repérer les postes à examiner et d’orienter les arbitrages avec les équipes concernées.
Mesurer la couverture, application par application
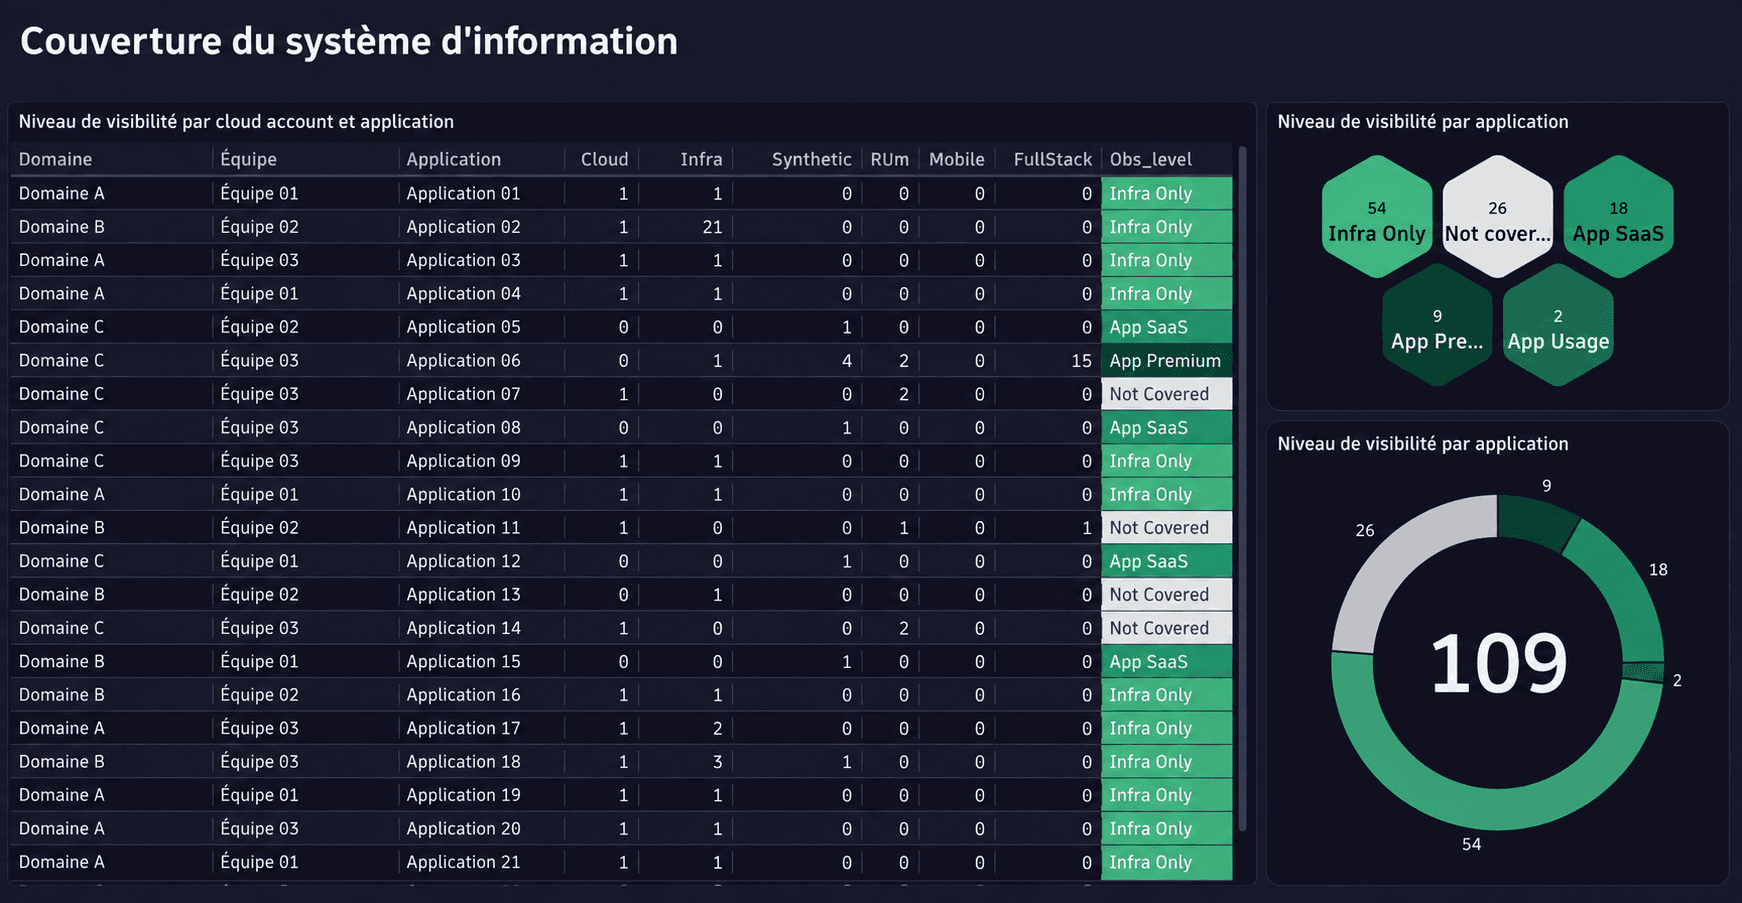
Chaque ligne rapproche une application des modes de collecte présents : cloud, infrastructure, tests synthétiques, expérience utilisateur, mobile et instrumentation complète. Les synthèses à droite répartissent 109 applications selon leur niveau de visibilité. Cette lecture aide à repérer les périmètres peu couverts et à prioriser les prochaines intégrations.
Installer une routine d’exploitation
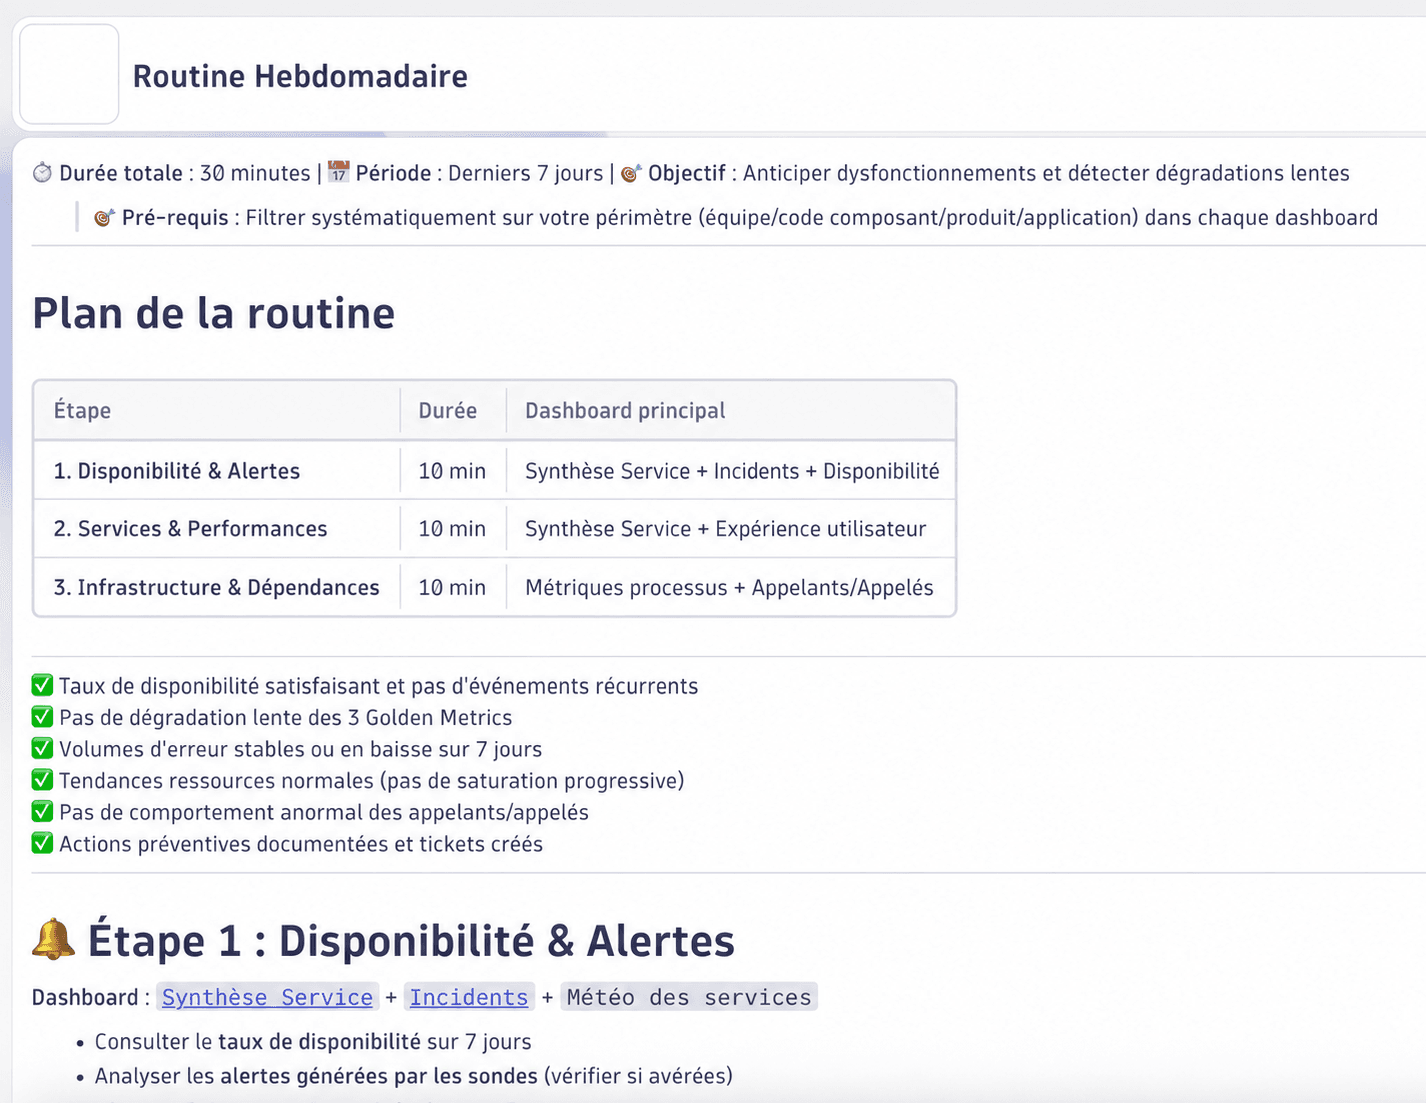
En trente minutes, les équipes examinent la disponibilité, les performances et les dépendances sur les sept derniers jours, puis documentent les actions préventives.
La progression se lit également dans la fréquentation quotidienne de la plateforme, la précision des questions et la diminution du besoin d’assistance à mesure que l’autonomie grandit. Les ateliers et les routines d’exploitation alimentent ainsi la prochaine étape de la feuille de route.
C’est cette continuité que Phenisys apporte à un projet d’observabilité d’envergure : un conseil relié aux enjeux métier, une intégration ancrée dans les opérations et un accompagnement en RUN qui fait progresser les pratiques. Vous préparez un déploiement ou souhaitez développer les usages de votre plateforme ? Échangeons sur vos priorités.
Autres articles
Toutes les ressourcesDiagnostiquer les incidents Microsoft Teams en quelques minutes : testez MS Teams Observability dans Dynatrace (mode démo)
Microsoft Teams est devenu un outil critique pour les entreprises. Réunions stratégiques, collaboration quotidienne, téléphonie, centres de contacts : quand Teams fonctionne mal, l’impact est immédiat pour les utilisateurs… et pour les équipes IT. Le problème, ce n’est pas l’absence de données.
Lire
Suivi du centre de contacts pour Microsoft Teams : les cas d’usage essentiels pour comprendre et améliorer vos appels
Un guide pour clarifier l’usage, équilibrer les flux et diagnostiquer les appels Teams.
Lire
Nouveauté Teams Téléphonie : la métrologie enfin accessible avec Microsoft Teams Observability by Phenisys
Dans la plupart des entreprises, Microsoft Teams est devenu le cœur de la communication interne et externe. Réunions, collaboration et désormais téléphonie d’entreprise : tout passe par Teams. Mais dès qu’il s’agit de qualité d’appel, de métriques réseau ou de diagnostic d’incidents, le constat est souvent le même : peu de visibilité, beaucoup de frustrations. […]
Lire